En una retransmisión deportiva hay información que cambia constantemente: marcador, tiempo de juego, alineaciones, estadísticas, goles, exclusiones, tarjetas, tiempos muertos, clasificación o resultados de otros partidos.
Tradicionalmente, buena parte de esos datos termina dependiendo de una persona que los introduce manualmente en el sistema de grafismo. El operador recibe la información, pulsa un botón, escribe un resultado o modifica un campo.
Funciona. Pero también introduce retrasos, errores y una dependencia innecesaria del equipo de realización.
En varios de mis proyectos he trabajado justo en el enfoque contrario: hacer que los datos oficiales del partido lleguen automáticamente hasta vMix y que el operador solo tenga que intervenir cuando realmente sea necesario.
El objetivo no es eliminar al operador. Es evitar que tenga que hacer tareas que una máquina puede realizar mejor.
El problema: demasiados datos para una realización en directo
Imaginemos una retransmisión de balonmano o fútbol.
Durante el partido pueden cambiar simultáneamente el resultado, el cronómetro, la posesión, los tiros, las faltas o sanciones, los jugadores que están en pista y los resultados del resto de la jornada.
Si cada uno de esos datos depende de una persona escribiéndolo manualmente, estamos creando varios puntos de fallo.
Un gol puede actualizarse tarde.
Una estadística puede quedarse congelada.
Un resultado puede introducirse incorrectamente.
O el operador puede estar ocupado lanzando una repetición precisamente cuando ocurre el evento que debería actualizar.
La solución pasa por separar completamente dos conceptos:
el dato y la realización.
El dato debería actualizarse automáticamente.
El operador debería decidir únicamente cuándo mostrarlo.
La arquitectura
La integración que suelo utilizar se puede simplificar así:
Proveedor deportivo → API → Backend de control → Datos normalizados → vMix
La API puede proceder de proveedores profesionales como Sportradar, Opta u otros servicios especializados, pero también de APIs propias de competiciones o plataformas deportivas.
El problema es que casi ninguna API entrega los datos exactamente como los necesitamos en televisión.
Por eso entre la API y vMix introduzco una capa intermedia.
No conecto vMix directamente contra la API deportiva.
Creo un backend encargado de recibir, procesar y normalizar toda la información.
Ese backend es, en realidad, el cerebro del sistema.
Normalizar antes de enviar a televisión
Una API deportiva puede devolver algo parecido a esto:
home_score
away_score
match_status
period
possession
shots_on_target
Para televisión probablemente queramos trabajar con otros nombres, estructuras e incluso formatos.
Por ejemplo:
LOCAL_GOLES
VISITANTE_GOLES
PARTE
TIEMPO
POSESION_LOCAL
POSESION_VISITANTE
Además, las APIs cambian.
Puede aparecer una estadística nueva, cambiar una etiqueta o llegar un dato vacío.
Si los gráficos dependen directamente de la estructura original de la API, cualquier modificación puede romper el sistema de emisión.
Por eso creo una capa de normalización que convierte los datos externos en un formato propio y estable.
La API puede cambiar.
Los grafismos no.
Un único estado del partido
Otro concepto importante es crear una especie de estado central del partido.
El sistema mantiene continuamente una representación interna del encuentro.
Por ejemplo:
{
  "local": "Equipo A",
  "visitante": "Equipo B",
  "goles_local": 24,
  "goles_visitante": 22,
  "periodo": 2,
  "tiempo": "48:32",
  "estado": "EN_JUEGO"
}
Los diferentes módulos leen siempre de ese mismo estado.
El marcador utiliza el resultado.
El grafismo de estadísticas utiliza las estadísticas.
El lower third de un jugador utiliza la plantilla.
La clasificación utiliza los resultados.
De esta forma evitamos que cada grafismo tenga que consultar por separado al proveedor deportivo.
Además de simplificar el sistema, esto es fundamental cuando se trabaja con APIs que tienen límites de peticiones.
No hay que consultar la API cada segundo
Uno de los errores más habituales al desarrollar este tipo de sistemas es pensar:
"Cuantas más peticiones haga, más actualizado estará."
No necesariamente.
Y además puede acabar bloqueándonos el proveedor.
La frecuencia de actualización debe depender del tipo de información.
Durante un partido en directo tiene sentido actualizar marcador, cronómetro o eventos con mucha frecuencia.
Sin embargo, no tiene ningún sentido consultar continuamente la clasificación completa, la información del pabellón o la plantilla de los equipos.
En mis sistemas separo los datos en diferentes niveles de actualización.
Hay información prácticamente estática que se descarga una vez.
Otra información puede actualizarse manualmente desde el panel.
Y únicamente los datos realmente relacionados con el directo permanecen actualizándose mientras el partido está en juego.
Cuando termina, esas consultas se detienen.
Esto reduce drásticamente las llamadas a la API y hace que el sistema sea mucho más estable.
¿Cómo llega todo esto a vMix?
Aquí tenemos varias posibilidades.
vMix dispone de una API HTTP bastante completa que permite modificar títulos, activar overlays, ejecutar funciones, cambiar inputs o controlar prácticamente toda la realización.
Pero para los grafismos me gusta separar otra vez dos responsabilidades.
Por una parte tenemos el contenido del gráfico.
Por otra, su entrada y salida de pantalla.
Los datos pueden actualizarse constantemente en segundo plano aunque el grafismo no esté visible.
Por ejemplo, el marcador puede estar recibiendo automáticamente:
24 - 22
24 - 23
25 - 23
25 - 24
Cuando realización decide poner el marcador en pantalla, este ya contiene el resultado correcto.
No necesitamos actualizarlo manualmente justo antes de mostrarlo.
Datos automáticos, decisiones manuales
Esta es probablemente la idea más importante de todo el sistema.
Automatizar los datos no significa automatizar la realización.
Hay acciones que tiene sentido ejecutar automáticamente.
Por ejemplo:
actualizar el marcador, sincronizar estadísticas, cargar convocatorias o actualizar los partidos de la jornada.
Pero hay otras decisiones que siguen perteneciendo al realizador.
Mostrar un grafismo de gol.
Lanzar una tarjeta.
Sacar una estadística.
Activar un lower third.
Mostrar una repetición.
Mi filosofía es sencilla:
la máquina mantiene preparada la información; el realizador decide qué contar y cuándo enseñarlo.
Así conseguimos automatización sin perder control editorial.
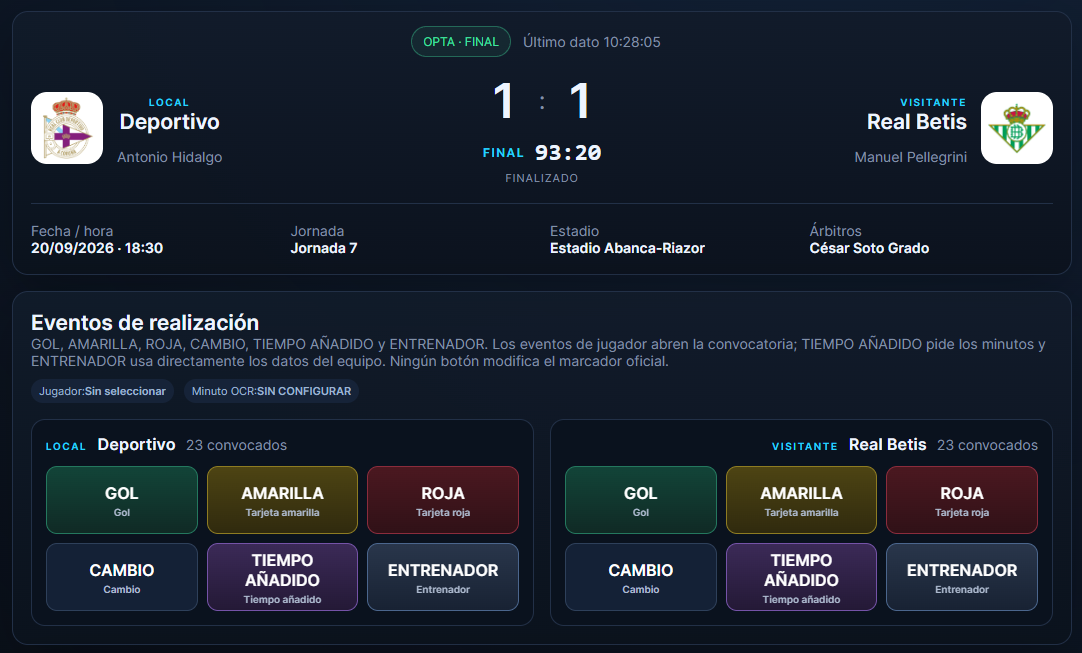
El panel de control
Para no depender directamente de la interfaz de vMix, suelo crear además un panel web intermedio.
Desde ese panel podemos ver el partido, comprobar la conexión con la API, consultar los jugadores, ver eventos y estadísticas y lanzar los diferentes grafismos.
Incluso podemos detectar automáticamente los inputs disponibles en vMix.
Esto permite crear botones como:
GOL LOCAL
TARJETA
CAMBIO
ESTADÍSTICAS
CLASIFICACIÓN
El operador no necesita saber qué input está utilizando vMix, qué endpoint hay que llamar o cómo está estructurada la API.
Pulsa un botón.
El backend hace el resto.
Separar la interfaz del motor
Esta separación tiene otra ventaja enorme.
Podemos cambiar completamente la interfaz sin modificar la lógica del sistema.
Podemos tener un panel completo para administración.
Una interfaz simplificada para realización.
O incluso un modo tablet, mostrando únicamente los controles necesarios durante el partido.
Todos ellos utilizan el mismo backend.
Esto permite construir sistemas mucho más fáciles de mantener y ampliar.
¿Y si falla la API?
En televisión siempre hay que asumir que algo puede fallar.
Internet puede caerse.
La API puede dejar de responder.
El proveedor puede alcanzar su límite de peticiones.
Por eso nunca me gusta diseñar estos sistemas pensando únicamente en el funcionamiento ideal.
El backend debe conservar el último estado válido recibido.
Si la API deja de responder durante unos segundos, los grafismos no deberían quedarse vacíos.
Además, determinadas variables críticas deberían poder corregirse manualmente desde el panel.
Especialmente el marcador.
La automatización tiene que reducir riesgos, no introducir otros nuevos.
Incluso podemos trabajar con varios proveedores
Una evolución interesante es desacoplar completamente el proveedor de datos.
Podemos definir internamente una estructura estándar y crear diferentes conectores.
Por ejemplo:
Proveedor 1
      ↓
Adaptador
      ↓
Formato interno
      ↓
Sistema gráfico

Proveedor 2
      ↓
Adaptador
      ↓
Formato interno
      ↓
Sistema gráfico

Proveedor 3
      ↓
Adaptador
      ↓
Formato interno
      ↓
Sistema gráfico
Para los grafismos da exactamente igual de dónde proceda la información.
Siempre reciben el mismo formato.
Esto permite incluso disponer de un proveedor secundario en caso de fallo del principal.
El resultado: menos operación y más realización
Cuando todo está correctamente integrado, la diferencia durante una retransmisión es enorme.
El realizador deja de estar pendiente de escribir números.
El operador de grafismo no necesita comprobar continuamente páginas externas.
Y desaparecen buena parte de los pequeños errores humanos que terminan apareciendo en una emisión en directo.
El equipo puede concentrarse en lo realmente importante:
contar el partido.
Ese es precisamente el tipo de automatización que más me interesa desarrollar.
No automatizar por automatizar.
Sino identificar aquellas tareas repetitivas que distraen al equipo técnico y construir herramientas que hagan que desaparezcan.
Porque una buena integración tecnológica debería funcionar de una forma muy sencilla:
los datos llegan solos, los gráficos siempre están preparados y el operador mantiene el control.